Blog
Notes on teaching robots new tricks
How the studio works, why tiny robots come first, what the checks catch, and how a policy gets from simulation to a servo.
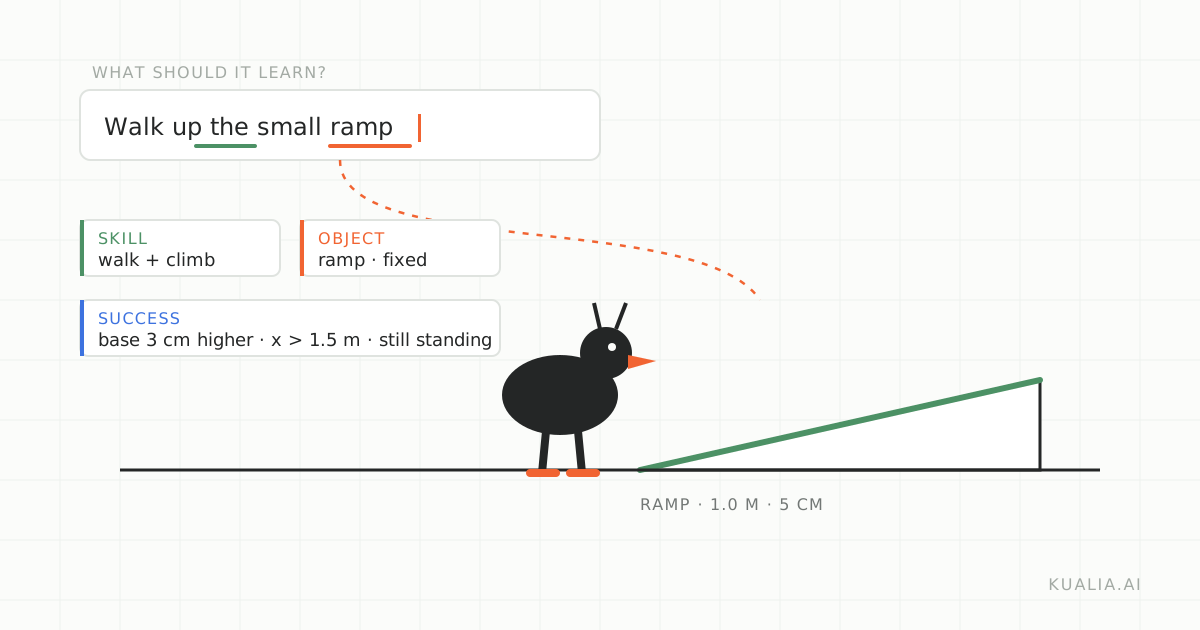 workflowopen-duck-miniSep 29, 2026 · 6 min readFrom a sentence to a walking duck: how kualia turns a plain-language brief into a training taskA walk through the whole kualia workflow, from a one-sentence brief to an ONNX policy, using the Open Duck Mini and a small ramp.Read the post
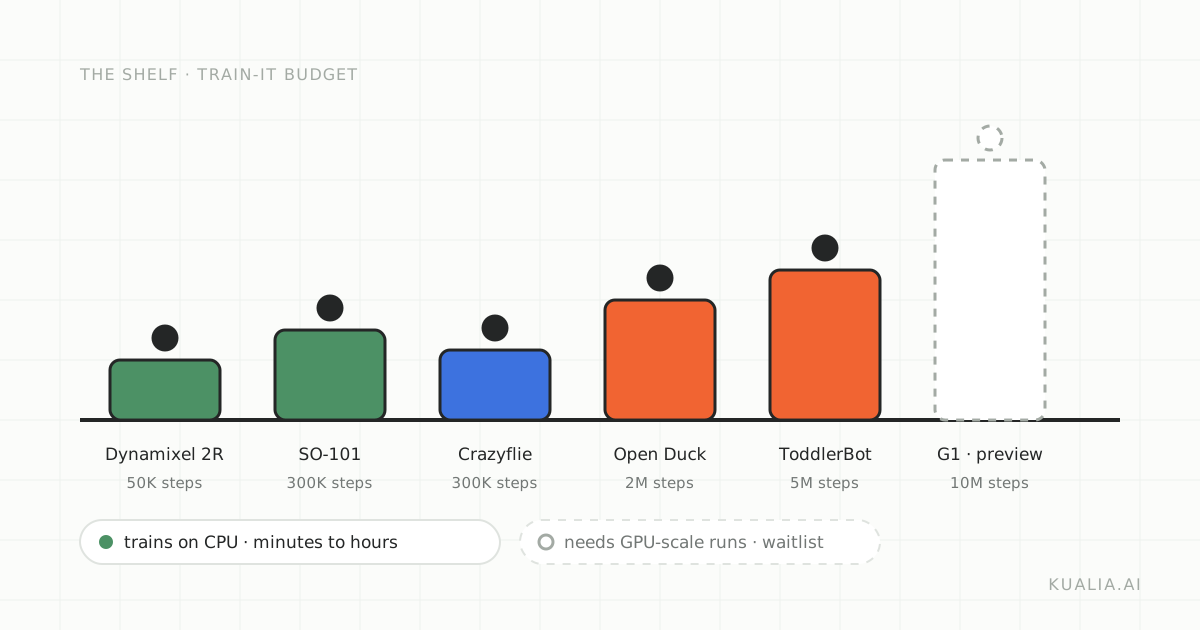 Sep 27, 2026 · 5 minWhy we start with tiny robotsDesk-sized robots train on CPU in minutes to hours, cost little to own and cross the sim-to-real gap without heroics. That is why kualia's shelf starts with them.
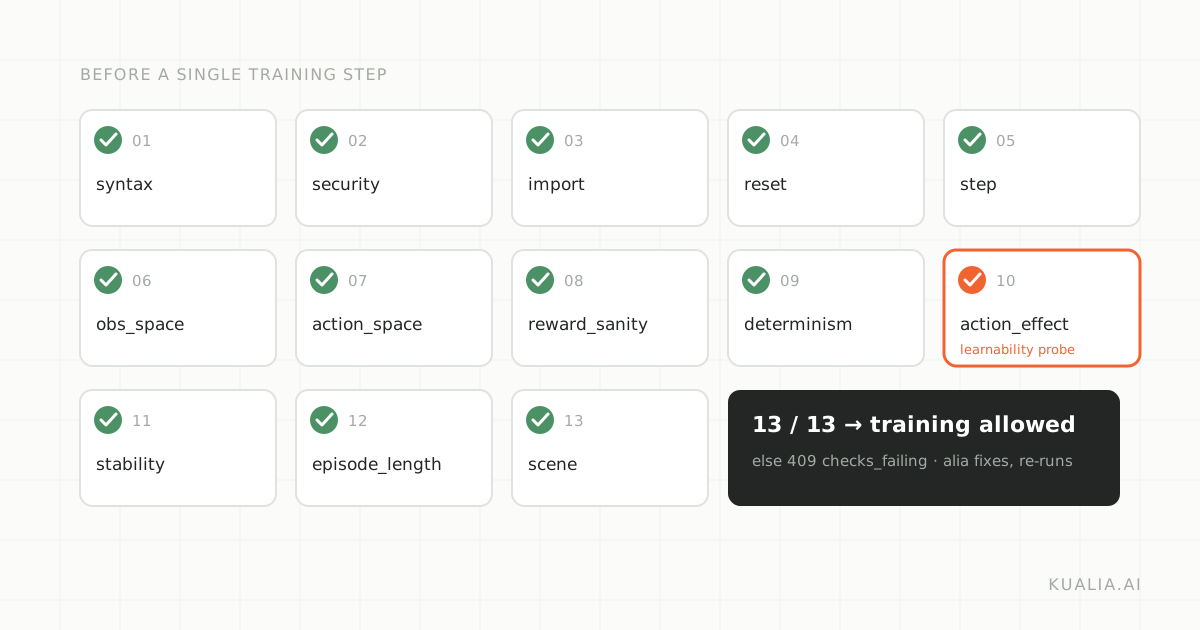 Sep 25, 2026 · 6 min13 checks before a single training stepalia writes the training task, but it does not get to grade its own work. Every task passes 13 sandbox checks before training can start. Here is what each one catches.
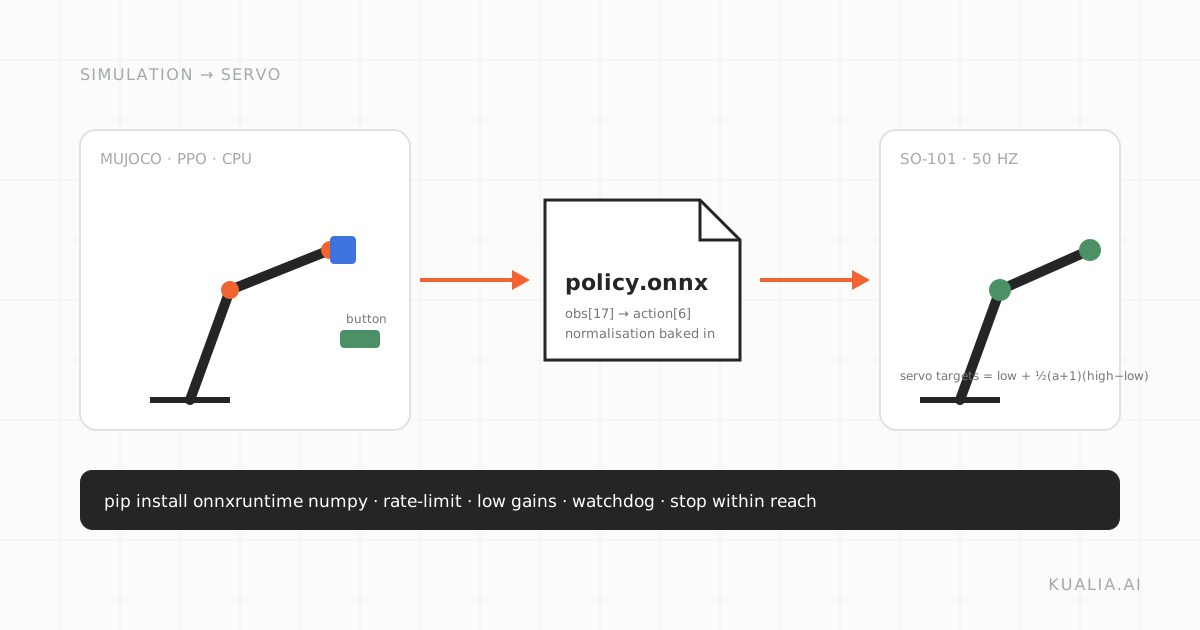 Sep 23, 2026 · 5 minFrom simulation to servo: running your ONNX policy on a real SO-101What is inside a kualia ONNX export, how to read its metadata, a minimal onnxruntime loop for the SO-101, and the sim-to-real checklist before you power the servos.
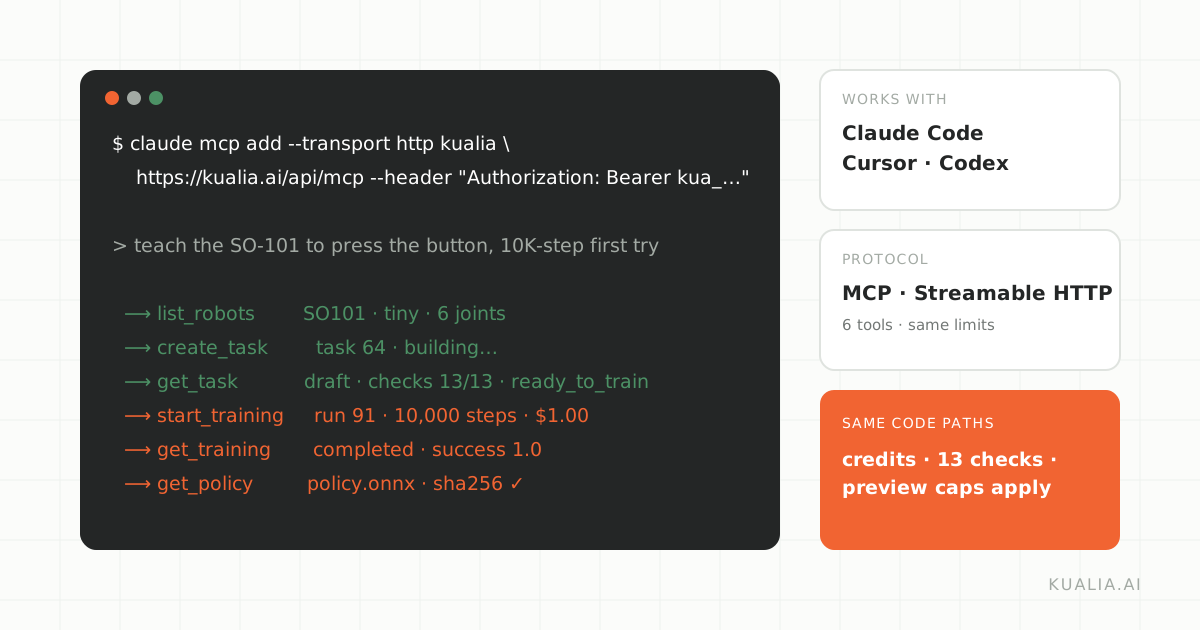 Sep 21, 2026 · 5 minLet your coding agent train the robotkualia is a remote MCP server. Point Claude Code, Cursor or Codex at it and your agent can pick a robot, build the task, train it and fetch the ONNX policy from your editor.
Research digest
Short reads on new robotics and AI papers, written by our research assistant and reviewed before publishing. 1,060 so far.
Page 41 of 59
Apr 1, 2026The Geometry of Superposition: Why Sparse Autoencoders Fail at Compositional GeneralizationThe mechanistic interpretability community is repeating the mistake of variational autoencoders. In the rush to understand large language models, we have traded theoretical rigor for computational convenience, assuming t Apr 1, 2026 · TRFederated Learning'de Gizlilik Tehlikesi: SOMP ve Büyük Dil Modellerinde Gradyan Tersine Çevirme Saldırıları Giriş Birleşik öğrenme (federated learning), özellikle sağlık, hukuk ve finans gibi hassas verilerin işlendiği alanlarda, veri gizliliğini korumak amacıyla yaygın olarak benimsenen bir paradigmadır. FedSGD protokolü alt Apr 1, 2026 Apr 1, 2026 · TROtonom Araçlarda Çok Kaynaklı ve Çok Modlu Verilerin Gizli Maliyeti: Yedeklilik Analizi Giriş Günümüz otonom araç ekosisteminde araştırma ve geliştirme faaliyetlerinin büyük çoğunluğu algoritmik mimarilerin iyileştirilmesine odaklanmış durumda. Daha büyük transformer modelleri, daha karmaşık attention meka Apr 1, 2026The Redundancy Paradox: Why Less Data Improves Perception in Autonomous VehiclesAutonomous vehicles rely on a sensor architecture that treats redundancy as a safety imperative. The prevailing assumption has been simple; more sensors observing the same scene provides insurance against individual sens Apr 1, 2026 · TRYaratıcılığın Tokenleştirilmesi: CAT ve Akıllı Tüketim Çağında Yaratıcı Üretim Giriş Metinden görüntüye (text-to-image, T2I) modelleri son yıllarda görsellik kalitesi ve istem bağlılığı (prompt adherence) açısından belirgin ilerlemeler kaydetti. FLUX.1 gibi modeller, kullanıcıların verdiği metinse Apr 1, 2026 Apr 1, 2026 · TRBatch Normalization'da İstatistiksel Örnekleme: Hesaplama Maliyetini Azaltmanın Yeni Yolu Giriş Derin sinir ağlarının (Deep Neural Networks, DNN) eğitiminde karşılaşılan gradyan patlaması ve yok olması sorunlarını çözmede Batch Normalization (BN), 2015'ten bu yana vazgeçilmez bir bileşen haline gelmiştir. Io Apr 1, 2026The Statistical Efficiency of Batch Normalization: Why Sampling Trumps Hardware OptimizationBatch Normalization has become the silent workhorse of modern deep learning. Since its introduction by Ioffe and Szegedy in 2015, it has enabled the training of architectures hundreds of layers deep, stabilized optimizat Apr 1, 2026 · TR Apr 1, 2026Metamemory in Machines: Autonomous Synthetic Curation for Code Generation Introduction The prevailing paradigm for improving large language model performance on specialized tasks relies heavily on curated datasets and carefully engineered prompts. In code generation, this dependency creates a Apr 1, 2026 · TRNovoMolGen ve Moleküler Dil Modellerinde Ön Eğitim Paradoksu: Perplexity ile Performans Arasındaki Kopukluk Giriş İlaç keşfi ve yeni molekül tasarımı, insanlığın karşı karşıya olduğu en karmaşık bilimsel mücadelelerden biri olmaya devam ediyor. Kimyasal uzayın devasa boyutları (tahmini sentezlenebilir 10^23 ile 10^60 arası ad Apr 1, 2026The Perplexity Trap: Why Molecular Language Models Need to Rethink Pretraining Objectives Introduction The hunt for novel therapeutic molecules confronts one of computational chemistry's most daunting statistics: the space of synthesizable drug-like molecules spans an estimated 10^23 to 10^60 candidates. Nav Mar 31, 2026 · TRVideo Düzenlemede Yapı ve Hareketin Ayrıştırılması: SAMA ve İçsel Temsillerin Yükselişi Giriş Yapay zeka destekli video üretimi ve düzenleme alanında son yıllarda kaydedilen ilerlemeler, difüzyon modellerinin görsel dünyayı modelleme kapasitesini gözler önüne seriyor. Ancak tek bir görüntüyü düzenlemekle, Mar 31, 2026Factorized Representations and the End of External Scaffolding in Video EditingThe fundamental challenge in instruction guided video editing has always been the dual mandate. Models must execute precise semantic modifications specified by text prompts while simultaneously preserving the intricate t Mar 31, 2026 · TR Mar 31, 2026Uncertainty in Recurrent Computation: An Ensemble View of Temporal Credit AssignmentRecurrent neural networks have long served as the workhorse for sequential data processing, from natural language processing to the modeling of biological neural populations. Yet beneath their widespread application lies Mar 31, 2026 · TRSequoia: Sürekli Öğrenme Araştırmalarını Birleştiren Hiyerarşik Çerçeve ve Uzmanlaşma Paradoksu Giriş Sürekli Öğrenme (Continual Learning, CL), yapay zeka sistemlerinin durağan olmayan (non-stationary) ortamlarla etkileşim halindeyken zaman içinde bilgi ve beceri biriktirmesini amaçlayan bir araştırma alanıdır. Bu