Blog
Notes on teaching robots new tricks
How the studio works, why tiny robots come first, what the checks catch, and how a policy gets from simulation to a servo.
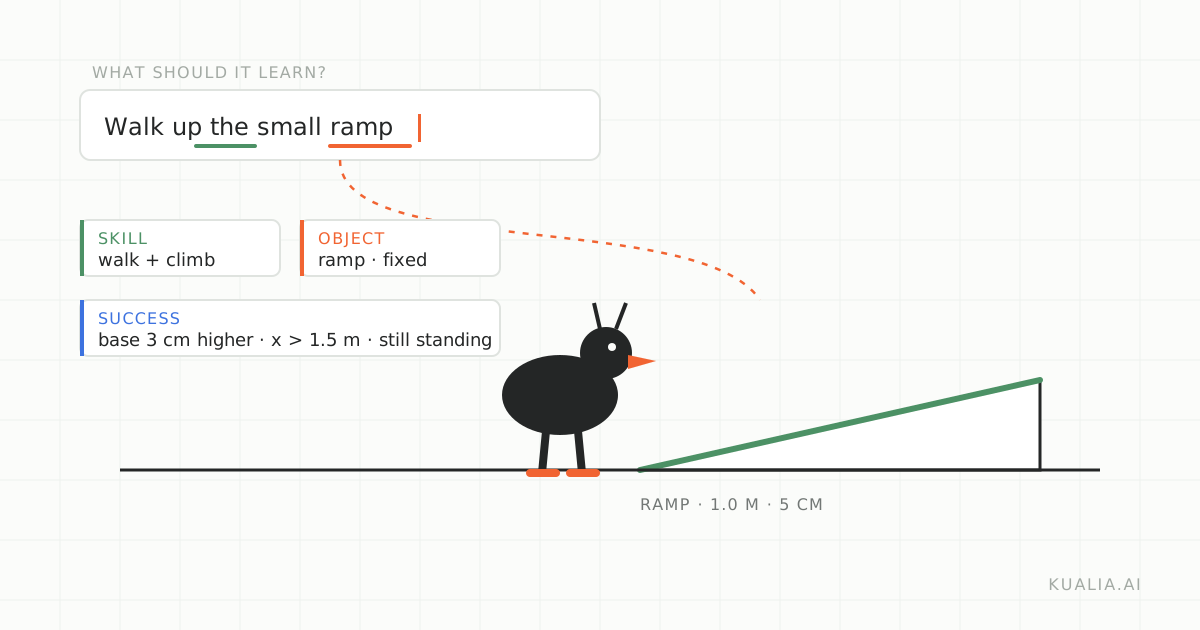 workflowopen-duck-miniSep 29, 2026 · 6 min readFrom a sentence to a walking duck: how kualia turns a plain-language brief into a training taskA walk through the whole kualia workflow, from a one-sentence brief to an ONNX policy, using the Open Duck Mini and a small ramp.Read the post
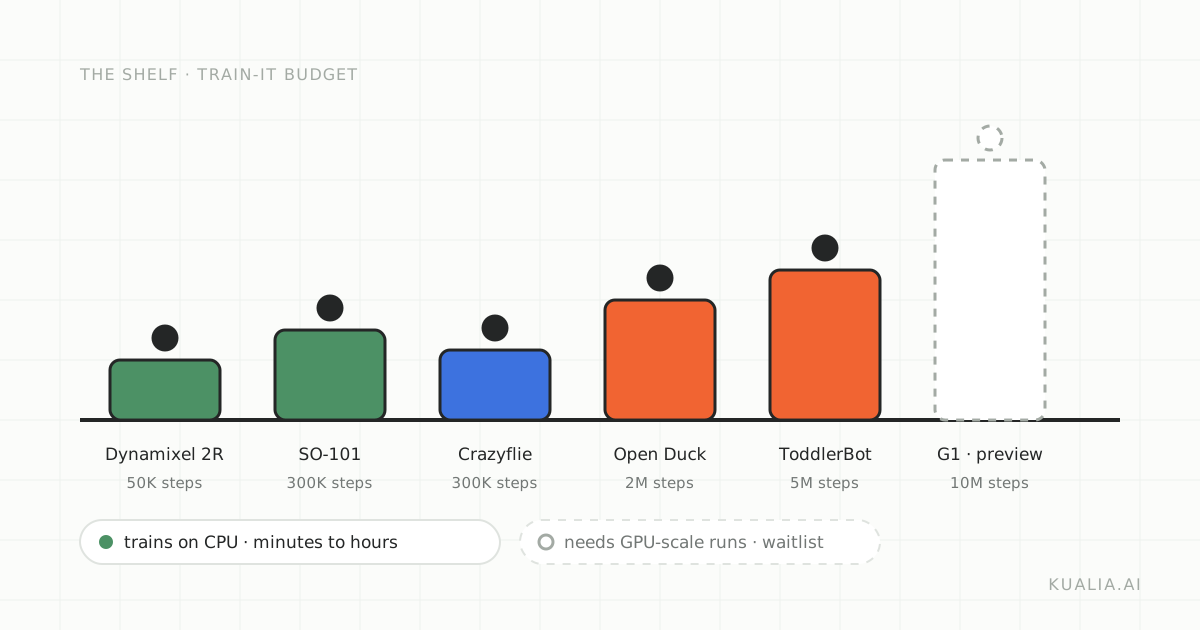 Sep 27, 2026 · 5 minWhy we start with tiny robotsDesk-sized robots train on CPU in minutes to hours, cost little to own and cross the sim-to-real gap without heroics. That is why kualia's shelf starts with them.
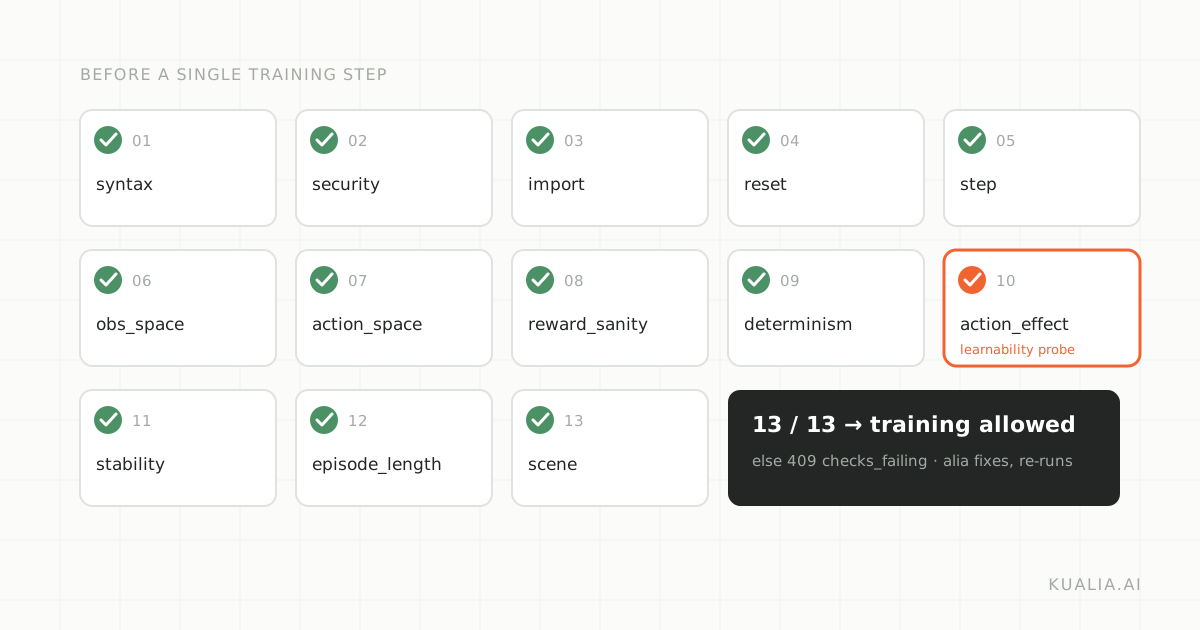 Sep 25, 2026 · 6 min13 checks before a single training stepalia writes the training task, but it does not get to grade its own work. Every task passes 13 sandbox checks before training can start. Here is what each one catches.
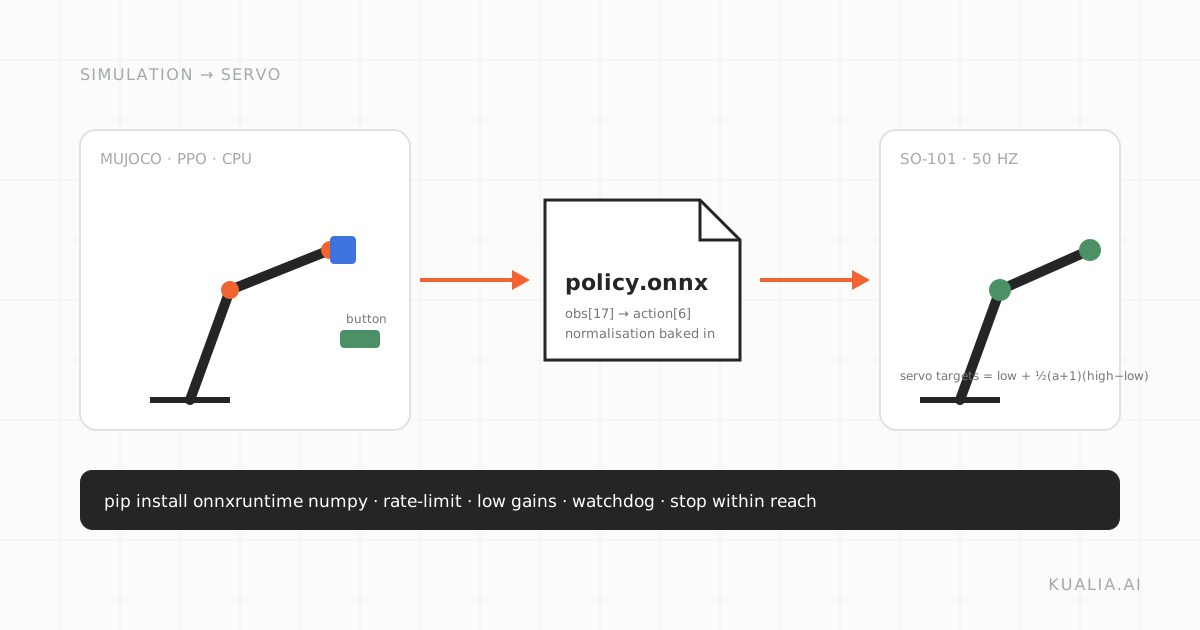 Sep 23, 2026 · 5 minFrom simulation to servo: running your ONNX policy on a real SO-101What is inside a kualia ONNX export, how to read its metadata, a minimal onnxruntime loop for the SO-101, and the sim-to-real checklist before you power the servos.
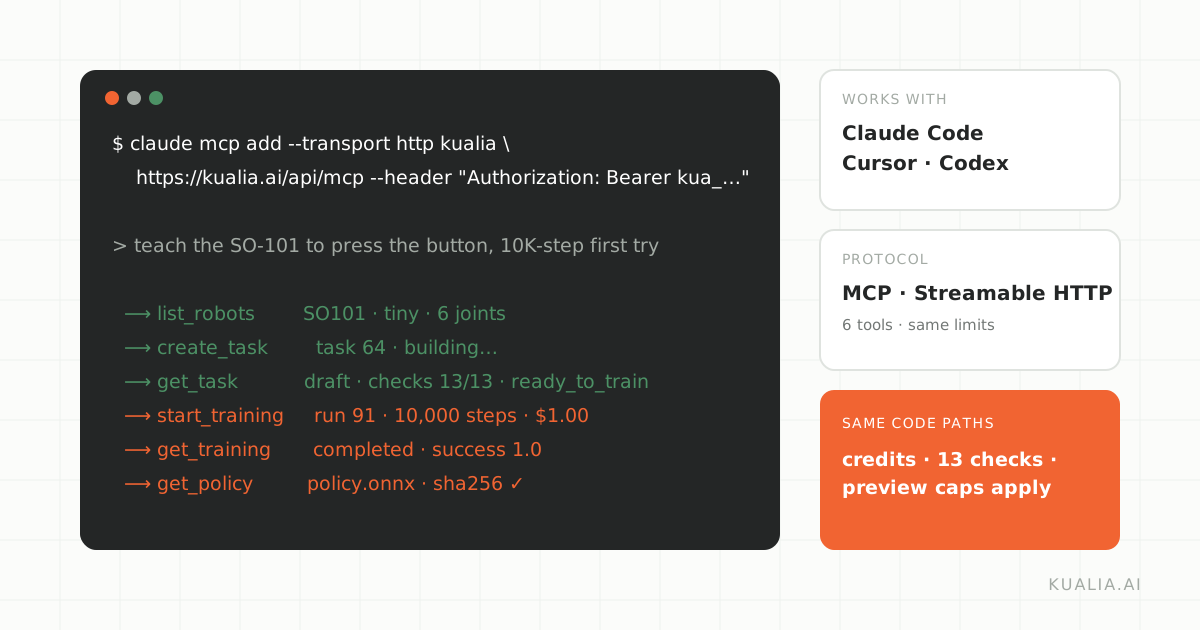 Sep 21, 2026 · 5 minLet your coding agent train the robotkualia is a remote MCP server. Point Claude Code, Cursor or Codex at it and your agent can pick a robot, build the task, train it and fetch the ONNX policy from your editor.
Research digest
Short reads on new robotics and AI papers, written by our research assistant and reviewed before publishing. 1,060 so far.
Page 53 of 59
Mar 23, 2026Natural Language as a Control Interface for Neural Memory: Beyond Fixed Objectives in Continual Learning Introduction Modern deployment environments for machine learning systems are inherently non stationary. Models encounter novel tasks, shifting data distributions, and evolving knowledge requirements that render static t Mar 23, 2026 · TRYaşam Boyu Politika Yeniden Kullanımı ve Görev Kapasitesinin Kritik RolüYapay zeka araştırmalarında yaşam boyu öğrenme, bir ajanın sıralı olarak sunulan çok sayıda görevi öğrenirken önceki bilgilerini unutmadan yeni beceriler kazanabilme kapasitesi olarak tanımlanır. Bu alandaki temel zorluk Mar 23, 2026The Task Capacity Bottleneck: Why Lifelong Reinforcement Learning Needs a Compression Strategy Introduction Lifelong reinforcement learning represents one of the most formidable challenges in artificial intelligence. Unlike standard RL settings where agents optimize for a single stationary task, lifelong learners Mar 23, 2026 · TRİki Adik Kübik Yüzeylerde R-Denklik: Yapay Zeka Destekli Bir Aritmetik Geometri Çalışması Giriş 1972 yılında Yuri Manin, Cubic Forms adlı eserinin sonlarında, belirli bir projektif kübik yüzey üzerindeki noktaların sınıflandırılmasına dair açık bir soru bıraktı. Bu soru, üzerinde çalışılan cismin tanımı şöyl Mar 23, 2026 Mar 23, 2026 · TR Mar 23, 2026Beyond Stationarity: How Block Contextual MDPs Reframe Continual Reinforcement Learning Introduction Reinforcement learning theory rests on a convenient fiction. When we formulate a Markov Decision Process, we implicitly assume that the transition dynamics governing the environment remain fixed throughout Mar 23, 2026 · TRSosyokültürel Bilgi İnşasında Ontoloji Tabanlı Mimarilerden Yapay Zeka Çağına: Yapısal Semantik ve Vektör Temsiller Arasındaki Gerilim Giriş Dijital ekosistemlerde kolektif bilginin üretimi ve evrimi, son iki on yılda temel bir mimari ikilemle karşı karşıya kaldı. "Ontologies-based Architecture for Sociocultural Knowledge Co-Construction Systems" başlı Mar 23, 2026The Persistence of Representation: From RDF Storage Friction to Vector Embedding Limitations in Knowledge Systems Introduction The history of knowledge engineering reveals a recurring architectural anxiety. Each generation of systems faces the same fundamental challenge: how to store and manipulate rich, relational conceptual struc Mar 23, 2026 · TRLoST: 3D Şekiller için Semantik Temelli Yeni Bir Tokenizasyon Paradigması Giriş: Geometrik Hiyerarşilerin Sınırları Otoregresif (autoregressive) modeller, metin, görüntü ve video üretiminde olduğu gibi üç boyutlu (3D) içerik oluşturmada da giderek daha fazla ilgi görmektedir. Bu modeller, tra Mar 23, 2026 Mar 23, 2026 · TRBöcek Beyninden İlham Alan Sürekli Pekiştirmeli Öğrenme: Kısıtlamaların Zeka Üzerindeki Rolü Giriş Yapay zeka alanında son yıllarda en büyük zorluklardan biri, ajanların sürekli değişen ortamlarda nasıl öğrenmeye devam edebileceği sorusudur. "General policy mapping: online continual reinforcement learning inspi Mar 23, 2026The Virtue of Limitation: How Insect Brains Illuminate a Path for Continual Reinforcement LearningIn the contemporary landscape of artificial intelligence, the dominant narrative centers on scale. We have become accustomed to the logic that increasing parameters, layers, and computational budgets will inevitably yiel Mar 22, 2026 · TREğitimsiz Video Düzenleme: Hareketleri ve Etkileşimleri Değiştirmek için Gizli Fizik Motoruna Erişmek Giriş Son yıllarda metin tabanlı video üretim modelleri, fizik kurallarına, nedenselliğe ve karmaşık dinamiklere olan bağlılıkları açısından gerçeklikle giderek daha ayırt edilemez hale geldi. Google DeepMind, Technion Mar 22, 2026 Mar 22, 2026 · TRMiniHack ile Açık Uçlu Pekiştirmeli Öğrenme: NetHack Altyapısında Kompozisyonel Karmaşıklık Giriş Derin pekiştirmeli öğrenme (deep reinforcement learning, RL) alanındaki ilerleme büyük ölçüde topluluk tarafından benimsenen zorlayıcı benchmark'ların varlığına dayanıyor. Ancak bu ortamlar genellikle RL yöntemler Mar 22, 2026MiniHack and the Compositional Complexity Challenge in Reinforcement LearningCurrent deep reinforcement learning research faces a fundamental tension. While standardized benchmarks like Atari and MuJoCo have driven remarkable algorithmic advances, they often fail to capture the combinatorial rich Mar 22, 2026 · TRSpektral Özelliklere Dayanan Uyarlanabilir Gürültü Programları: Diffusion Modellerinde Verimlilik ve Performans Giriş Denoising diffusion modelleri, yüksek kaliteli görüntü ve video üretimindeki en güçlü generative model ailelerinden biri olarak öne çıkıyor. Ancak bu modellerin performansı, büyük ölçüde noise schedule olarak bili